Chargement...
Sans Limites
Open Range
Mathématiques | Informatique | Recherche Appliquée | Modélisation et Simulation
Nous résolvons vos problèmes les plus complexes.
En savoir plus sur nous

Idées

Vous avez une idée ? Vous ne savez pas par où commencer ? Nous pouvons vous aider. Nous travaillons avec vous pour cerner en profondeur vos défis et déterminer la meilleure marche à suivre.

Algorithmes

Nous transformons votre idée en algorithmes et en logique métier soigneusement mis en œuvre, qui peuvent être intégrés en toute fluidité à vos flux de travail existants.

Prototypes

La première étape est la plus difficile. Nous concevons un prototype fonctionnel pour vous aider à valider votre idée et à tester le marché.

Histoires

Même les meilleures idées doivent être partagées pour avoir un impact. Nous ciblons votre public et présentons votre produit avec le niveau de détail technique approprié.

À propos de nous

Nous utilisons les mathématiques et le génie logiciel pour résoudre des problèmes techniques et aider les entreprises à comprendre les systèmes complexes dont elles dépendent.

Nous apportons notre expertise en mathématiques et en développement logiciel pour automatiser des processus manuels chronophages et optimiser les algorithmes de calcul sur lesquels reposent ces activités.

Nous avons mis ces compétences au service du département de la Défense des États-Unis, notamment pour automatiser une tâche manuelle d'étiquetage de données qui prenait 6 heures, et pour concevoir des visualisations de l'activité cérébrale.

Grâce à une expérience allant de la recherche fondamentale au développement logiciel, nous pouvons nous intégrer aisément à toute équipe au sein de votre organisation et communiquer efficacement avec des interlocuteurs possédant des niveaux de connaissances techniques variés.

Projets sélectionnés

Vous souhaitez travailler avec nous ?

Nous sommes toujours ouverts aux projets intéressants.

Découvrez notre équipe
Member Photo
Mathématiques et informatique

Richard Kublik
Consultant principal

  • Richard possède une aptitude particulière à traduire des concepts mathématiques et analytiques complexes en prototypes logiciels robustes. Sa spécialité réside véritablement dans la résolution de problèmes et l'exécution.
    Derek Doran
    Tenet3, Directeur de la R&D
  • Richard s'investit toujours dans la réussite du projet et travaille avec assiduité pour résoudre les problèmes, en veillant à communiquer les solutions de manière à ce que les autres membres de l'équipe les comprennent. Intelligent et doté d'une grande clarté dans sa communication, Richard est une personne avec qui il est toujours agréable de travailler.
    Rob Keefer
    Pomiet

Quelle est la différence entre un tight end et un receveur ?

Il s'avère qu'il s'agit de la question la plus complexe dans le football NFL.

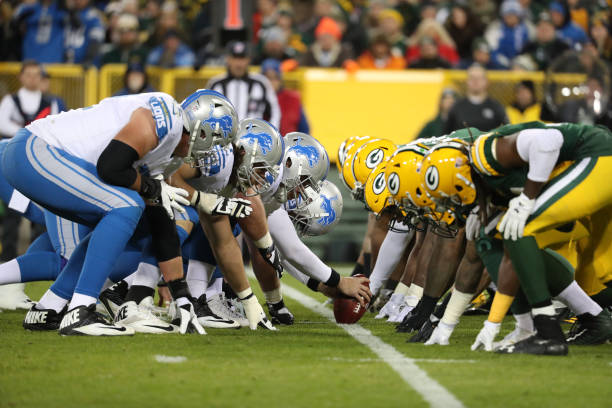
Des joueurs de football américain alignés au début d'une phase de jeu

Eh bien, peut-être pas, mais c'était la question la plus délicate d'un projet sur lequel j'ai travaillé.

J'ai aidé une société d'analyse du football à automatiser son processus d'étiquetage des données. Pour chaque jeu, dans chaque jeu, tout au long de la saison, l'équipe d'étiquetage des données a mis l'enregistrement en pause et a identifié les joueurs sur le terrain et leur poste. Cela semble simple : vérifier la composition de l'équipe, scanner les numéros sur les maillots et c'est fait. Pas tout à fait. Il y a des moments où les joueurs sont dans un poste différent pour un jeu où vous ne pouvez pas voir clairement le maillot. Le Le manuel d'annotation suggère d'identifier les joueurs en utilisant d'autres caractéristiques que leur uniforme, comme la couleur de leurs lacets par exemple. Pas si facile.

La vie s'est améliorée lorsque la NFL a commencé à suivre les joueurs. Désormais, le poste de chaque joueur sur le terrain est enregistré plusieurs fois par seconde. Mon projet était de prendre les données de suivi et le guide et de créer un algorithme pour étiqueter tous les joueurs, sans regarder leurs lacets.

Une fois le quarterback identifié, la plupart des postes offensifs étaient faciles à définir : le centre juste devant, les « guards » et les « tackles » de chaque côté, et les « wide receivers » sur les ailes. Pour les postes défensifs, le manuel de référence décrivait des zones très précises par rapport aux joueurs offensifs et à la distance par rapport à la ligne d'engagement (« line of scrimmage »). Il est difficile d'estimer ces distances à la télévision, mais c'est très simple lorsque l'on connaît le poste exact de chaque joueur.

Revenons au « tight end » : il ne fait pas partie de la ligne offensive, mais ce n'est pas non plus un « wide receiver ». Selon le manuel, le « tight end » a une main posée au sol, contrairement au « wide receiver ». C'est facile à distinguer quand on peut voir les joueurs, mais les données de suivi ne précisent pas la position des mains. Heureusement, nous disposions de données annotées couvrant une année entière. Une analyse rapide nous a permis de définir un seuil de distance : les joueurs situés en deçà de cette distance par rapport à la ligne offensive étaient considérés comme des « tight ends », et ceux au-delà comme des « wide receivers ». Ce n'était pas une solution parfaite, mais le client a pu définir un seuil qui lui convenait.

Au final, l'algorithme a donné d'excellents résultats. Il a fallu de nombreuses itérations, des comparaisons avec les annotations existantes et des échanges avec le client pour cerner certaines subtilités qui nous posaient problème. J'ai développé un outil de visualisation qui s'est avéré extrêmement utile ; nous avons même découvert des cas où les annotations initiales étaient erronées. Au début de la saison de football suivante, le client disposait d'une solution opérationnelle en laquelle il avait toute confiance.

Ce projet s'est révélé bien plus plaisant que je ne l'aurais imaginé. Je ne suis pas très porté sur le sport et je n'ai (encore) jamais regardé un match de football américain. Au début, c'était devenu une sorte de plaisanterie récurrente, mais en réalité, le projet ne portait pas vraiment sur le football. Il s'agissait avant tout de comprendre les données, d'en extraire les informations pertinentes et de fournir une solution fonctionnelle. Ça, c'est dans mes cordes.

Ne m'attendez pas, je vous rattrape

Les simulations de l'activité électrique dans les cellules nerveuses reposent sur la résolution de grands systèmes d'équations différentielles non linéaires des milliers de fois pour chaque seconde de temps simulé. Ces simulations peuvent nous aider à mieux comprendre comment certaines parties du travail cérébral, mais ils prennent beaucoup de temps et coûtent cher en termes de calcul.

Le coût de calcul comporte deux composantes principales : la taille du domaine physique qui correspond au nombre d'équations dans le système et au nombre de fois que nous devons résoudre les équations. Il existe un paramètre appelé le pas de temps qui contrôle se dernier : plus le pas de temps est petit, plus le nombre de resolutions des équations augmente. En général, un système qui évolue rapidement (avec un niveau d'activité élevé) nécessite un petit pas de temps pour capturer les changements avec précision.

Dans l'approche la plus naïve, la taille du pas est constante pour toute la simulation et est déterminée en fonction du niveau d'activité le plus élevé attendu à tout moment pendant la simulation. Ceci est simple à mettre en œuvre, mais entraîne un coût de calcul très élevé notamment quand le système évolue lentement sauf pendant une courte période au sein de la simulation.

Une approche plus raffinée consiste à utiliser un pas de temps adaptatif. A chaque mise à jour, le pas sélectionné est basé sur l'évolution la plus rapide à cet instant, n'importe où dans le domaine physique. Cela peut réduire le coût de calcul, et ce n'est pas plus compliqué à mettre en œuvre que la première méthode. En fait, comme la première méthode, il existe des paquets standards disponibles dans la plupart des bibliothèques informatiques pour selectionner le meilleur pas.

Parfois, dans les simulations neuronales, le système d'intérêt est très vaste, mais il n'y a qu'un petit nombre de régions avec une activité élevée à tout moment. La plupart du système peut être simulé avec un grand pas, mais comme il y a toujours certaines régions à forte activité, la simulation doit sélectionner un petit pas. J'ai développé un algorithme pour traiter ces cas.

J'ai développé un algorithme de pas de temps localement adaptatif (Locally Adaptive Time Stepping -- LATS). Dans ce schéma, le domaine spatial est divisé en sous-domaines, et chaque sous-domaine est mis à jour avec un pas de temps adaptatif le plus approprié pour le niveau local d'activité. Chaque sous-domaine évolue à son rythme, et attend que ses voisins rattrapent leur retard. Le défi est de maintenir le flux précis d'informations et la stabilité de la solution.

Grâce à l'application de techniques de décomposition de domaines, j'ai pu connecter informatiquement les sous-domaines en utilisant les conditions aux limites obtenues grâce à la conservation du flux. Pour répondre aux problèmes de stabilité, j'ai remplacé le schéma de temps utilisé pour les simulations en neurosciences depuis les années 1960 avec une méthode qui fournit une meilleure stabilité et s'est avérée mieux adaptée à l'algorithme LATS.

Évaluer l'algorithme LATS n'est pas aussi simple que d'affirmer une réduction de X % du temps de calcul. Le schéma numérique sous-jacent est comparable à l'approche standard, mais le principal avantage de la méthode LATS est que le coût de calcul évolue avec le niveau d'activité du système, et non avec la taille physique du domaine. Ainsi dans les situations où l'activité est faible dans une vaste région de calcul, la méthode LATS fournit un avantage de taille et une réduction du coût de calcul en concentrant les ressources de calcul là où elles sont le plus nécessaires. La méthode LATS a été développée dans le contexte des neurosciences computationnelles, mais est applicable à tout système ayant une activité clairsemée.

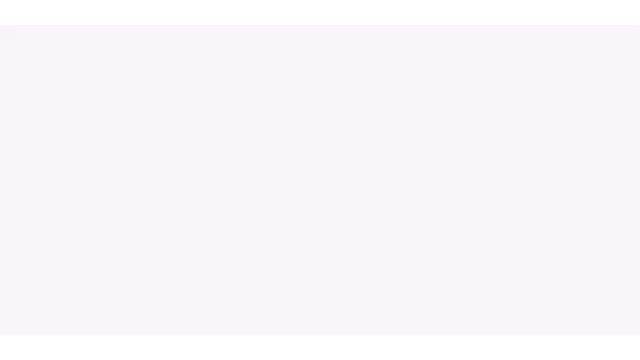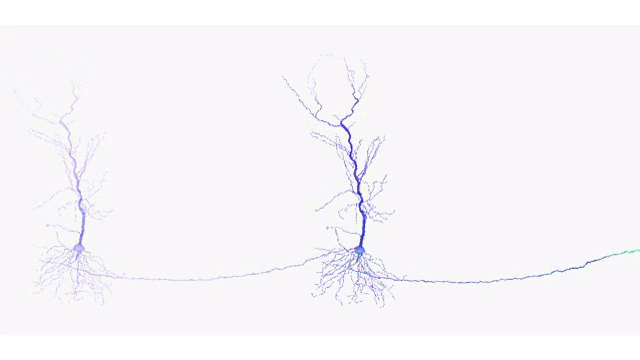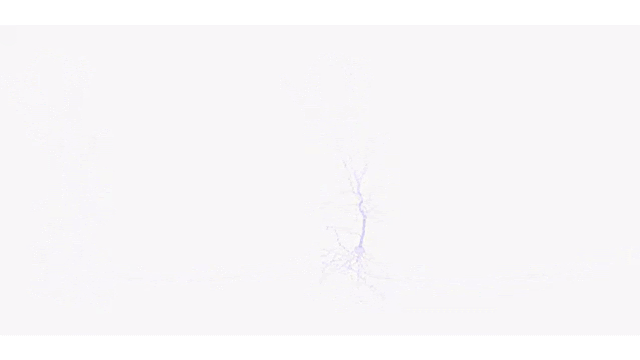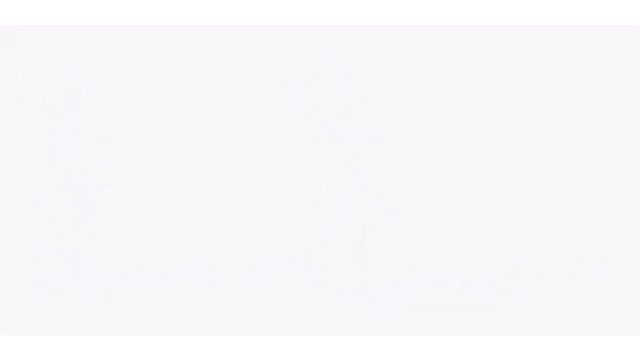
Dans l'animation ci-dessous, une impulsion électrique est initiée dans une cellule et se propage à travers deux cellules. Les couleurs représentent le niveau de la tension électrique et les sections de la cellule deviennent transparentes à mesure que la taille du pas augmente.

Impulsion électrique se propageant à travers deux cellules nerveuses.

Trop de documents

personnes assistant à une conférence

Nous avons travaillé avec un client du gouvernement (que nous appellerons « ATL » – acronyme de trois lettres), membre d'une vaste organisation multinationale, que nous nommerons « Big Org ». ATL souhaitait accroître son influence au sein de Big Org et avait besoin de comprendre comment les dynamiques politiques et les processus internes influençaient les décisions finales.

Nous avions accès au référentiel de données de Big Org, qui contenait plus de 2 téraoctets de documents textuels, un volume en constante augmentation. Il s'agissait d'un véritable défi : donner du sens à une telle masse de données textuelles, qui n'étaient ni indexées ni organisées.

J'ai dirigé une équipe composée de 5 ingénieurs et data scientists chargée de collecter, d'analyser et d'interpréter ces données pour ATL. Nous avons développé des outils ainsi qu'un pipeline automatisé permettant d'identifier et de récupérer de nouvelles données depuis le référentiel, d'en extraire les métadonnées et de les stocker dans une base de données afin de les rendre exploitables. Nous avons analysé ces métadonnées pour dégager des tendances d'activité et, en concertation avec ATL, nous avons approfondi nos recherches. Nous avons eu recours à des modèles d'apprentissage automatique (machine learning) pour effectuer des analyses thématiques et des analyses de sentiments, et avons créé des visualisations de données interactives pour aider le client à explorer ces informations.

Dès le début du projet, ATL soupçonnait qu'un groupe au sein de Big Org exerçait une influence disproportionnée sur le processus de décision. Nous avons réussi à réunir des éléments confirmant cette hypothèse et avons identifié certains des mécanismes par lesquels cette influence s'exerçait.

J'ai beaucoup apprécié ce projet, qui m'a permis de me concentrer davantage sur les objectifs stratégiques et les concepts globaux. Comme pour chaque projet, j'ai beaucoup appris : j'ai acquis des compétences techniques et des connaissances dans un nouveau domaine, j'ai développé mes capacités de direction d'une équipe pluridisciplinaire, et j'ai perfectionné mes compétences en présentation pour exposer nos travaux au client. Il a été très gratifiant de voir les membres les plus juniors de mon équipe développer leurs propres compétences et contribuer au projet par leurs idées et leurs savoir-faires.

Un modèle des premiers stades du diabète de type 1

Le diabète de type 1 survient lorsque le système immunitaire attaque et détruit les cellules bêta du pancréas, responsables de la production d'insuline. Notre collaborateur, dans le cadre de ses travaux expérimentaux, a observé que les macrophages — des éléments du système immunitaire chargés d'éliminer les cellules mortes présentes dans les tissus — issus de souris prédisposées au diabète de type 1 étaient moins efficaces que ceux provenant de souris saines. Il a par ailleurs été constaté que toutes les souris prédisposées à la maladie ne la développe pas. À partir de ces observations, nous avons élaboré un modèle visant à répondre à deux questions :

  1. La différence d'efficacité des macrophages peut-elle expliquer les disparités observées entre les souris saines et les souris prédisposées ?
  2. Le phénomène naturel de mort des cellules bêta, qui survient au cours du développement normal chez toutes les souris, pourrait-il constituer un événement déclencheur du diabète de type 1 chez les souris prédisposées ?
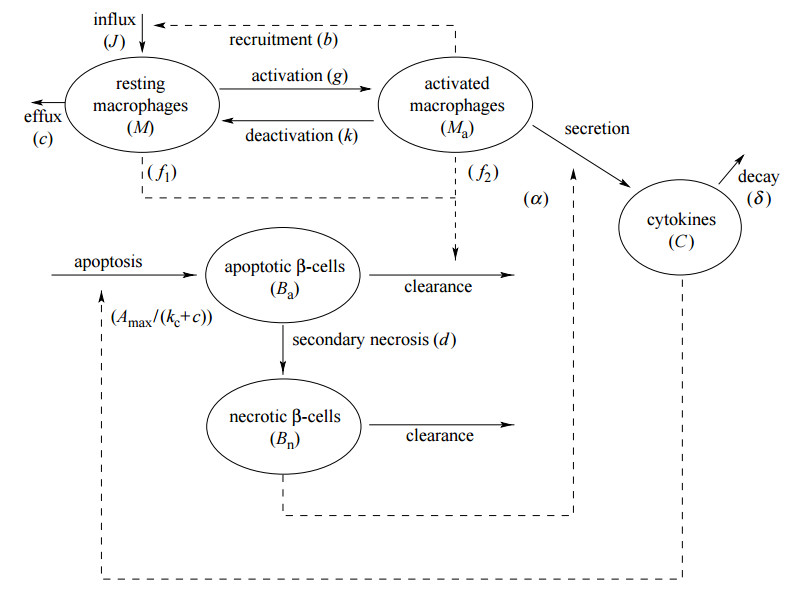
schéma du modèle mathématique

Dans notre cadre de modélisation, l'état sain correspond à une solution d'équilibre caractérisée par l'absence d'inflammation, tandis que l'état pathologique correspond à une solution d'équilibre caractérisée par une inflammation chronique. On suppose alors que, durant cet état d'inflammation chronique, le système immunitaire est sensibilisé de manière à attaquer et à détruire les cellules bêta pancréatiques. Étant donné que toutes les souris prédisposées ne développent pas le diabète de type 1, l'état sain doit exister et être stable pour les deux souches de souris modélisées. Par ailleurs, l'état d'équilibre correspondant à une inflammation chronique doit également exister et être stable chez les souris prédisposées. Grâce à des approches fondées sur les systèmes dynamiques (notamment l'analyse dans le plan des phases), nous avons déterminé que le modèle initial ne permettait pas de satisfaire ces exigences avec des valeurs de paramètres biologiquement plausibles. Le modèle a donc été enrichi pour inclure des populations cellulaires supplémentaires, ainsi que l'effet toxique de cytokines nocives libérées par les macrophages. Ce modèle étendu, présenté ci-dessous, a montré que des différences dans l'efficacité des macrophages pouvaient expliquer l'écart entre les souris saines et les souris prédisposées.

Pour répondre à la seconde question, le phénomène de mort des cellules bêta a été intégré au modèle. Celui-ci a révélé que, chez les souris saines, l'inflammation temporaire s'estompait rapidement, permettant au système de revenir à l'état d'équilibre sans inflammation. En revanche, chez les souris prédisposées, la mort des cellules bêta suffisait à faire basculer le système vers un état d'inflammation chronique ; cela suggère que la mort cellulaire, survenant naturellement, pourrait constituer un déclencheur du développement du diabète de type 1.